Cuando sale un modelo nuevo, todo son demostraciones espectaculares. Unas semanas después, el mismo modelo hace menos con el mismo prompt. No es una sensación: ya ha pasado, está documentado y las empresas lo han tenido que reconocer.
Lingjiao Chen, Matei Zaharia y James Zou compararon GPT-4 en marzo y en junio de 2023. Identificando números primos, pasó del 84 % al 51 % de aciertos en tres meses, con el mismo nombre. El estudio está revisado y publicado en Harvard Data Science Review.
Mejoró en otras tareas, sí. Pero si tú lo usabas para esa, tenías un modelo peor y nadie te avisó.
Lo niegan hasta que lo reconocen
En septiembre de 2025, Anthropic tuvo que admitir que tres errores suyos habían empeorado las respuestas durante agosto y principios de septiembre. En la peor hora, uno de ellos afectaba al 16 % de las peticiones de Sonnet 4. Los usuarios lo notaron antes de que la empresa encontrara las causas.
Puede ser. Pero durante semanas el modelo respondió peor, y quien lo detectó fue el que paga.
El estreno es un escaparate
The Leaderboard Illusion, publicado en NeurIPS 2025, documentó que Meta probó 27 variantes privadas en Chatbot Arena antes de un lanzamiento. Lo que vemos el día del estreno es el mejor de muchos intentos. Lo que usamos después es otra cosa.
Eso también es empeorar. Cada intento extra es tiempo tuyo: leer la respuesta, encontrar qué falla y volver a pedirlo.
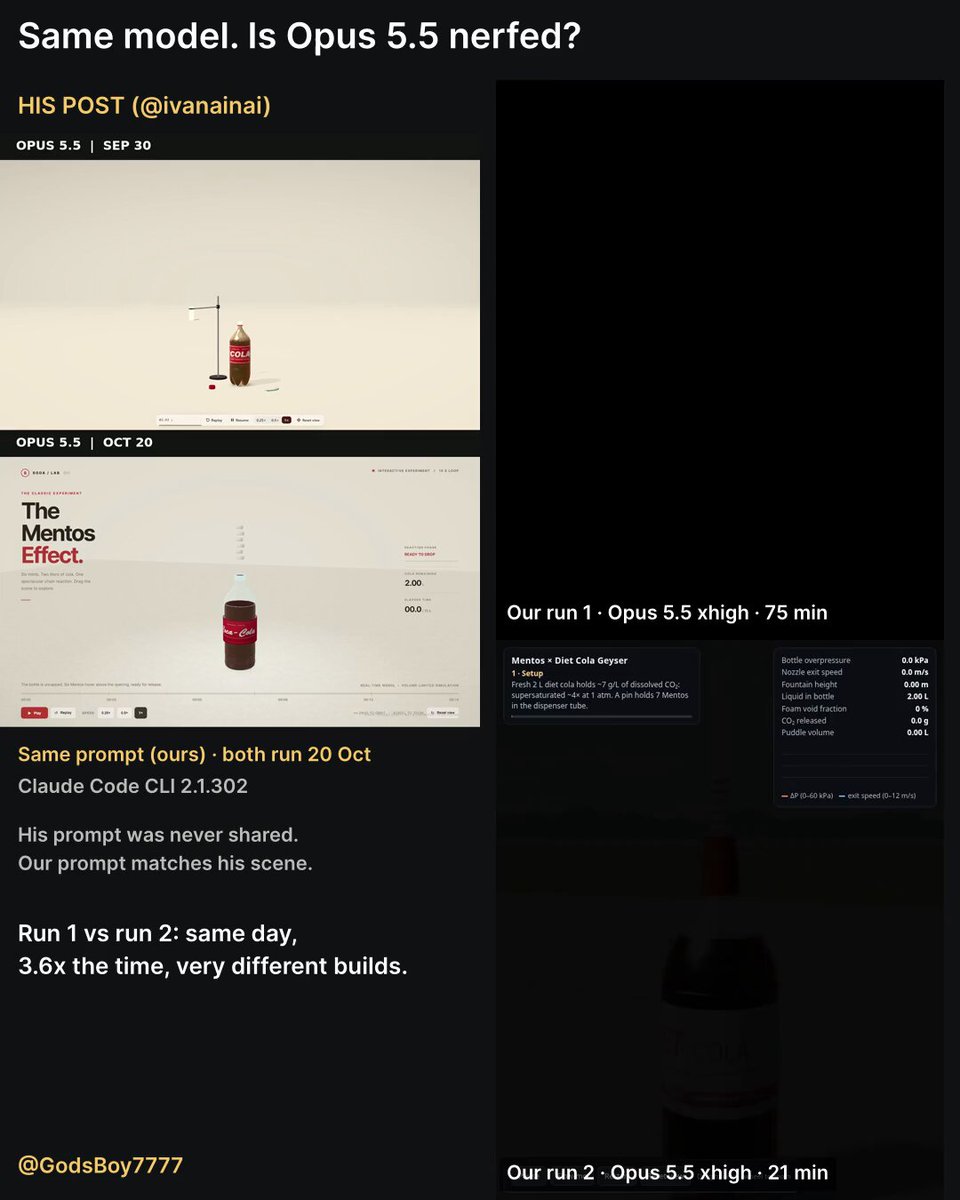
Ni siquiera el mismo día sale lo mismo. Dewaldt Huysamen ejecutó dos veces un prompt parecido con Opus 5.5, esfuerzo xhigh y la misma herramienta de terminal.
Pagas lo mismo y no sabes cuál de los dos te va a tocar.
El nombre no cambia, el modelo sí
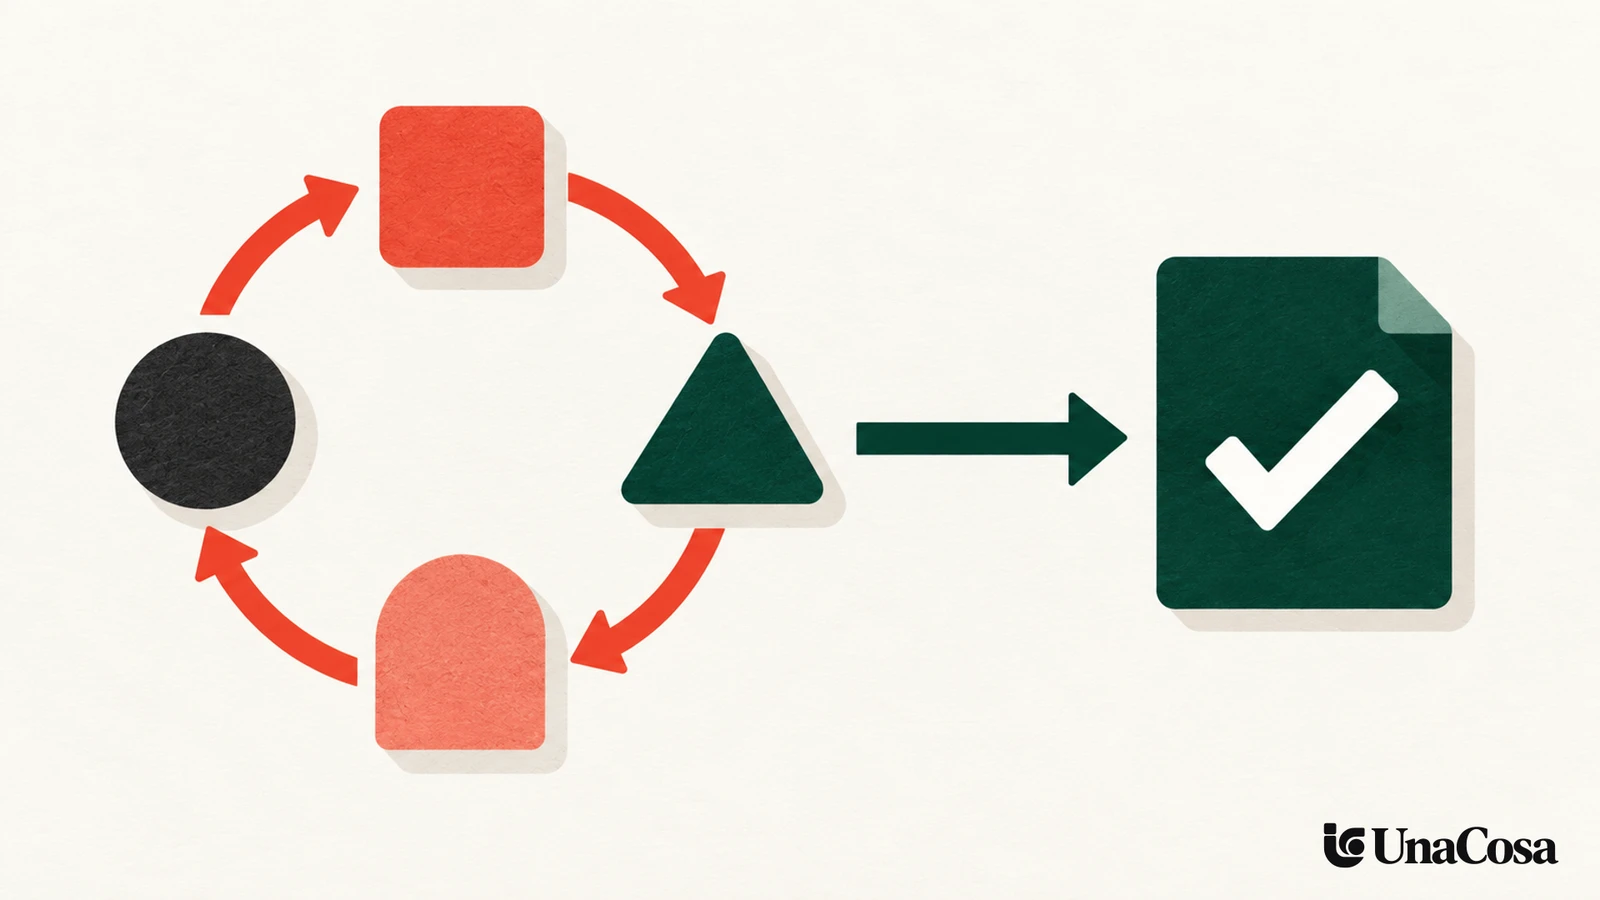
Lo que recibes no depende solo del modelo. El proveedor puede cambiar las instrucciones ocultas, las herramientas o el esfuerzo de razonamiento sin avisarte, y tú sigues viendo el mismo nombre.
1Modelo base
2Instrucciones y contexto
3Herramientas y esfuerzo de razonamiento
4Respuesta que recibes
Pizarro, Azanza y Pérez Lamancha siguieron durante veinte meses herramientas de IA para generar pruebas de software y encontraron regresiones. Tschisgale y Wulff fijaron todo lo que estaba en su mano con GPT-4o (versión, parámetros y prompt) y, aun así, los resultados de una tarea de física variaban según la hora y el día de la semana.
Lo que digo
Los modelos empeoran después del estreno. Hay regresiones demostradas, fallos que las empresas solo reconocen cuando no les queda otra, estrenos inflados y cambios que nadie te comunica.
¿Lo hacen a propósito para vendernos el siguiente? No lo puedo probar. Pero para quien paga da igual: el modelo que te enseñan el primer día no es el que usas un mes después.
Ivana@ivanainai
Traducido al español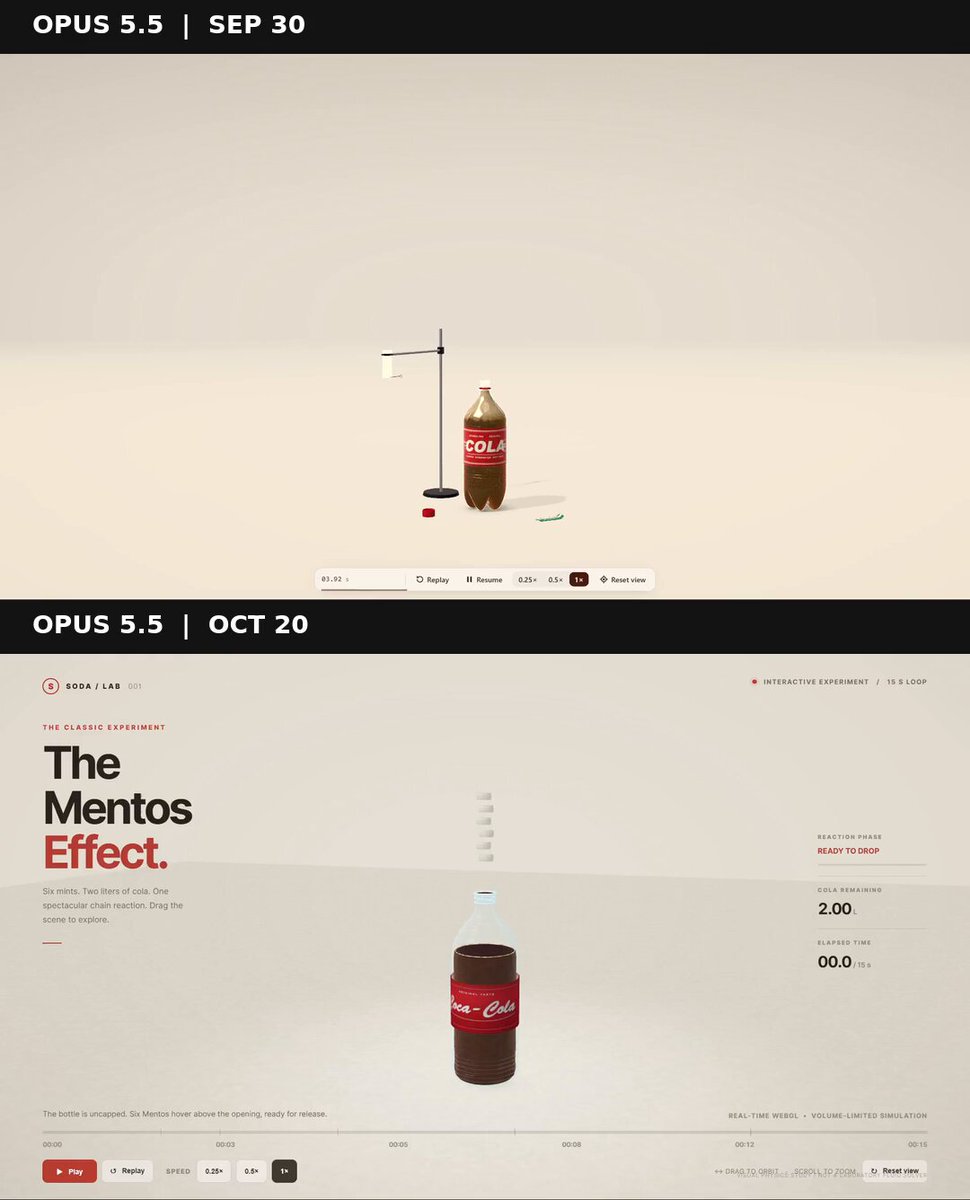

Haleemah@Haleeeemahh
Traducido al españolDewaldt Huysamen@GodsBoy7777
Traducido al español