Big Data: cuándo lo necesitas y cuándo estás complicando el problema
Volumen, velocidad y variedad explicados con un registro de sensores. Cómo decidir entre lotes, procesamiento continuo y una solución más sencilla.
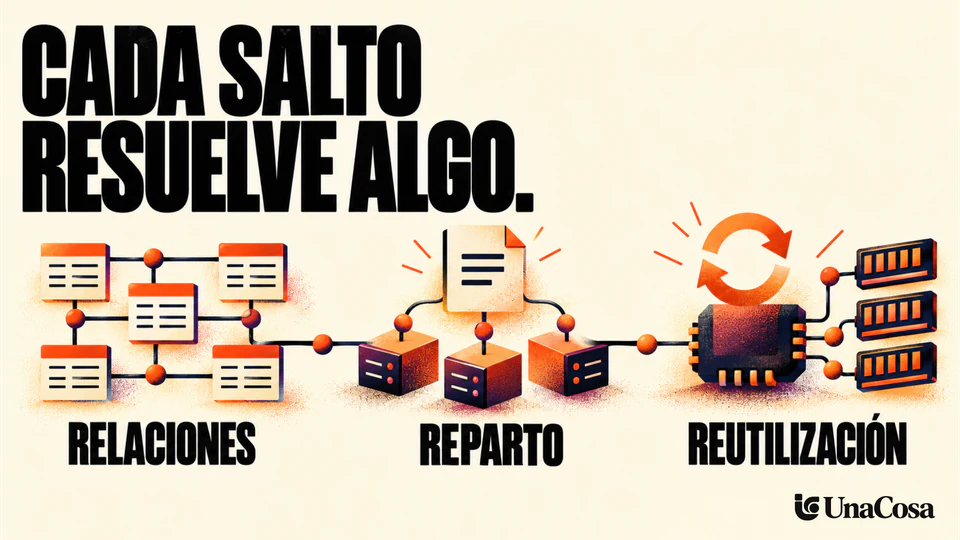
Procesar un archivo enorme durante la noche y responder a un flujo pequeño en segundos plantean problemas distintos. Big Data describe situaciones en las que la escala, la llegada o la diversidad de los datos obligan a replantear cómo se almacenan y procesan. Acumular filas, por sí solo, no dice qué infraestructura hace falta.
Las cinco V sirven para preguntar
Volumen, velocidad y variedad son tres dimensiones habituales. Veracidad y valor añaden dos preguntas indispensables: si la información merece confianza y para qué servirá. IBM las utiliza como marco de introducción. No existe un umbral universal que convierta cualquier proyecto en Big Data.
| Dimensión | Medida útil | Decisión que puede cambiar |
|---|---|---|
| Volumen | Datos nuevos por día y conservación | Capacidad y particionado |
| Velocidad | Demora máxima admisible | Lotes o procesamiento continuo |
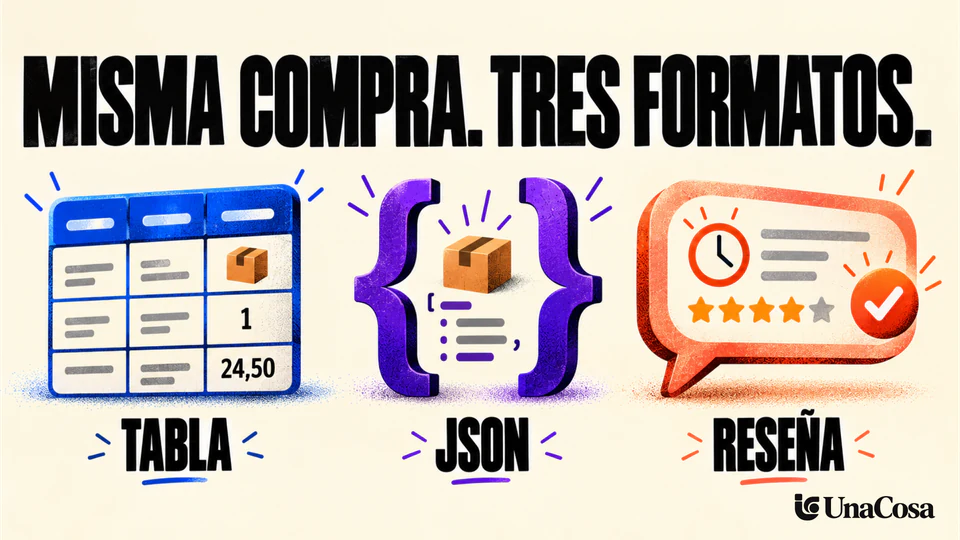
| Variedad | Fuentes, formatos y cambios | Adaptadores y contratos de datos |
| Veracidad | Duplicados, huecos y unidades | Validación y revisión |
| Valor | Acción y coste del error | Qué merece la pena construir |
Un ejemplo: lecturas de temperatura
Imagina, como ejercicio, 10.000 sensores que envían una lectura por minuto. Son 14,4 millones de lecturas al día. Si cada registro ocupase 100 bytes, el contenido bruto rondaría 1,44 GB diarios, antes de índices, réplicas, metadatos o compresión. Esa cuenta orienta el volumen; todavía falta saber qué hay que hacer con él.
Para preparar un informe semanal de máximos, puede bastar una carga por lotes. Para avisar de una temperatura fuera de rango, esperar al final de la semana ya no sirve. El segundo caso necesita un recorrido con una demora definida y una forma de tratar lecturas repetidas, retrasadas o ausentes.
Lotes y flujos: la pregunta es cuándo hace falta la respuesta
Un lote reúne datos y los procesa en un momento previsto. Un flujo trata los eventos a medida que llegan, normalmente agrupándolos en intervalos o ventanas. La elección afecta a la operación: recuperar una noche fallida y reconstruir el estado de un flujo interrumpido son problemas diferentes.
En un sistema de eventos hay dos horas relevantes: cuándo ocurrió la lectura y cuándo llegó. Si el dispositivo estuvo desconectado, una medida de las 10:00 puede aparecer a las 10:15. Contarla solo por su llegada deformaría el análisis del intervalo. Las herramientas de procesamiento, como Structured Streaming de Spark, ofrecen mecanismos que debes configurar para estos casos.
Antes de repartir el trabajo entre máquinas
Una consulta lenta puede deberse a que lee columnas innecesarias, carece de un índice adecuado o vuelve a calcular todo el histórico. Revisa primero el recorrido real. Distribuir una tarea añade coordinación, transferencia y recuperación; funciona cuando ese coste compensa el trabajo que se reparte.
- Mide una carga representativa, incluidos los momentos de mayor entrada.
- Anota tiempo de proceso, memoria, crecimiento y coste de repetir una tarea fallida.
- Prueba filtros, agregaciones y almacenamiento adecuados en la solución actual.
- Compara la alternativa con las mismas entradas y el mismo resultado esperado.
La dificultad suele estar entre las etapas
Una fuente cambia grados Celsius por Fahrenheit. Otra reenvía una lectura al recuperar la conexión. Una tercera borra datos antes de que lleguen al histórico. Puedes tener máquinas de sobra y producir un resultado equivocado por cualquiera de esas razones.
Big Data aporta medios para tratar problemas de escala. La BI se ocupa de convertir información en decisiones de negocio. Pueden encontrarse en un proyecto, pero el primer informe útil de una organización puede salir de una base de datos convencional.